AI企業のLiquid AIが小型AIモデル群「LFM3」を公開しました。スマートフォンやノートPCなどでも動作可能な小型モデルでありながら高い性能を備えており、いずれのモデルもオープンモデルとして公開されています。
Introducing LFM3: Every Modality for Specialized Intelligence | Blog | Liquid AI
https://www.liquid.ai/blog/lfm3
LFM3 登場:特化型インテリジェンスのためのあらゆるモダリティ | ブログ | Liquid AI
https://www.liquid.ai/ja/blog/lfm3
LFM3は基盤モデルのLFM3-1.7B-Baseをベースに派生したモデル群です。LFM3-1.7B-Baseは科学論文やコードや数学問題などを含む22兆トークンの学習データで事前学習されています。また、LFM3はAMDやQualcommなどのテクノロジー企業との連係のもとで開発されており、2026年1月にはLiquid AIのラミン・ハサニCEOがAMDのリサ・スーCEOとともにCES基調講演に登壇してLFM3をアピールしていました。
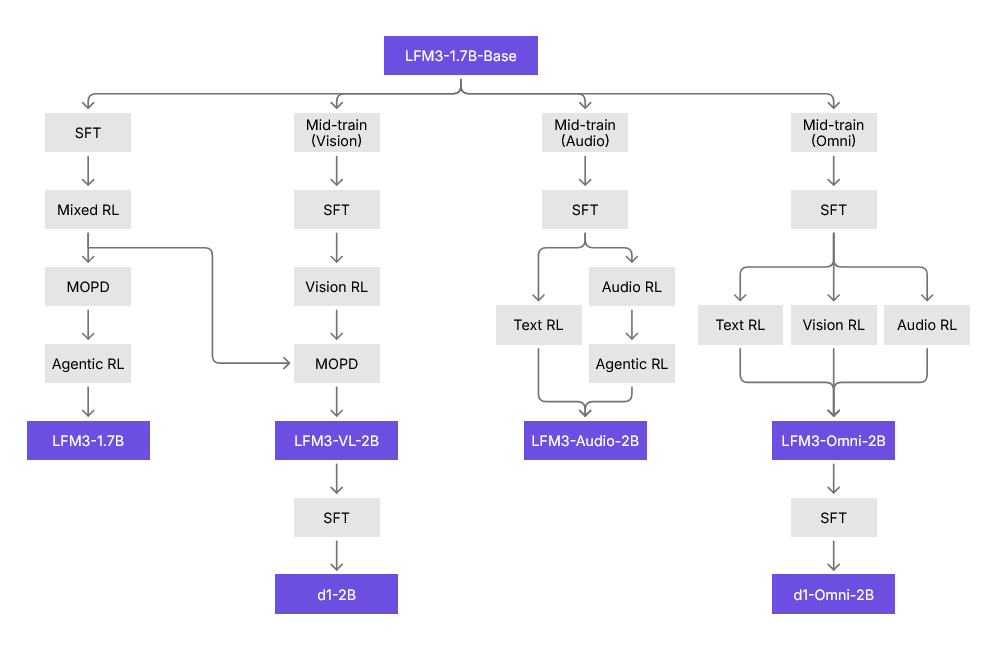
LFM3の最初のリリースにはLFM3-1.7B-Baseから派生した以下の6種類のモデルが含まれています。
LFM3-1.7B:テキストの入出力が可能な言語モデル
LFM3-VL-2B:テキスト・画像・動画の入力とテキストの出力に対応した視覚言語モデル
LFM3-Audio-2B:テキスト・音声の入出力に対応した音声モデル
LFM3-Omni-2B:テキスト・画像・動画・音声の入力とテキスト・音声の出力に対応したオムニモデル
d1-2B:テキスト・画像・動画の処理が可能な意思決定モデル
d1-Omni-2B:テキスト・画像・動画・音声の処理が可能な意思決定モデル
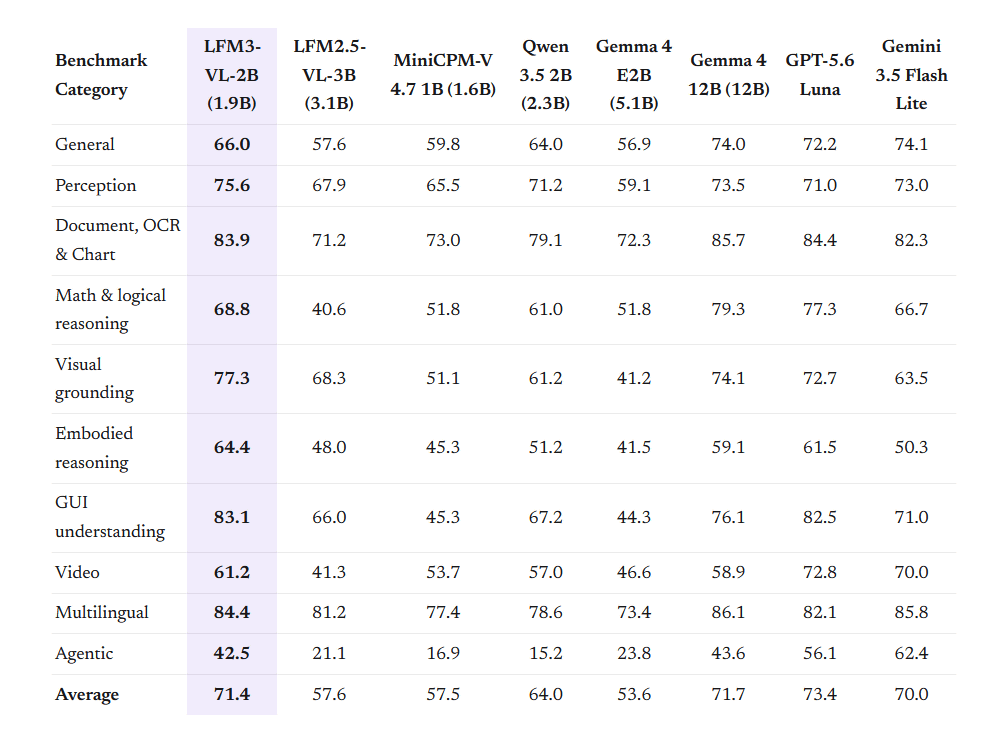
LFM3は同等規模のモデルと比べて高性能なことを特徴としています。例えば、LFM3-VL-2BはQwen3.5 2BやGemma 4 E2Bより高いベンチマークスコアを記録しており、一部のテストでははるかに規模の大きいGemma 4 12Bを上回っています。
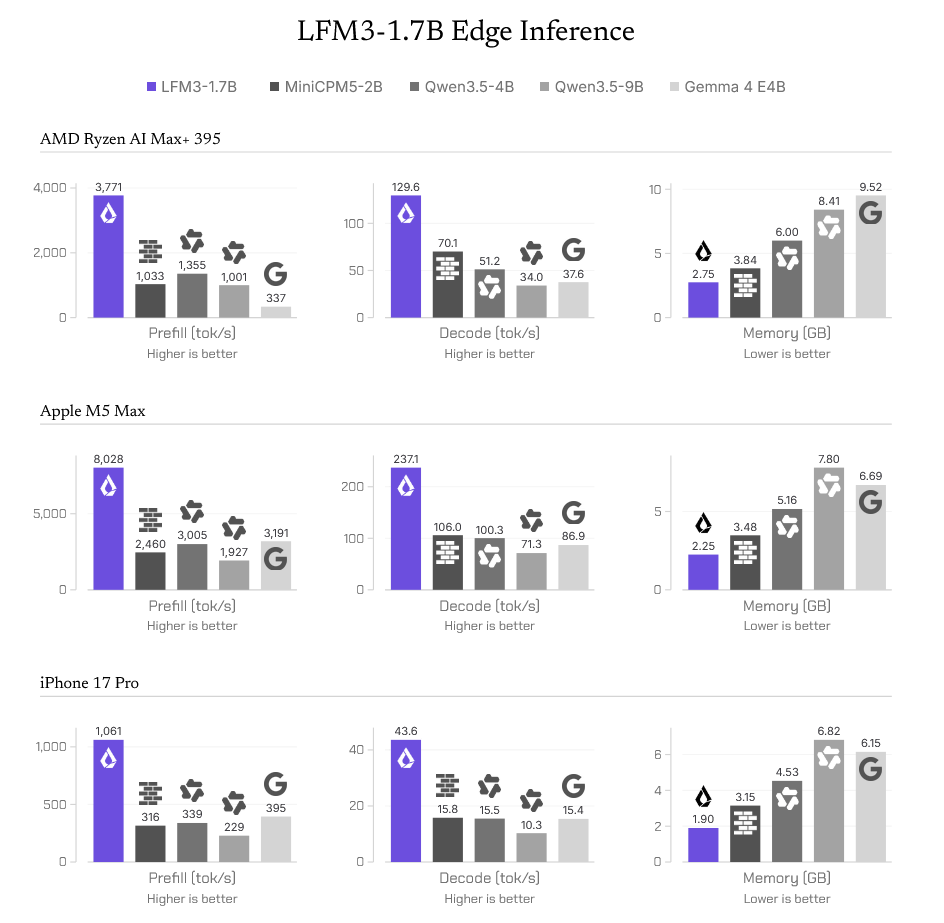
また、LFM3はスマートフォンなどの演算性能の低いデバイスでもローカル実行可能です。LFM3-1.7BをiPhone 17 Proで実行する場合、毎秒43.6秒という実用的な速度でデコード可能。メモリ使用量は1.90GBに抑えられています。
多言語性能の高さも長所です。以下の動画ではLFM3-Omni-2Bを用いて日本の道路を英語とドイツ語で案内する様子が示されています。
LFM3-Omni-2B: Multilingual Audio-Visual Q&A on the Move - YouTube
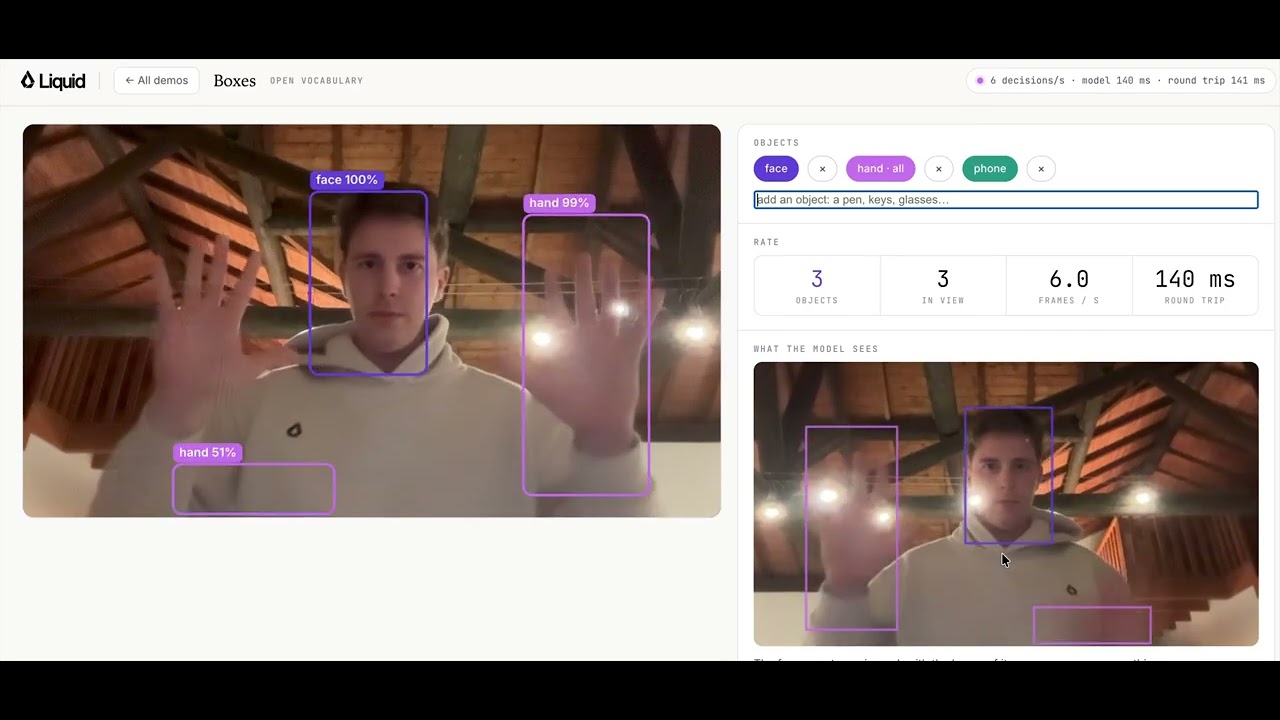
d1-2Bとd1-Omni-2BはJevと同様に「選択肢に対する判断」と「信頼度スコア」を出力できるモデルです。以下の動画ではd1-2Bを用いて体の部位やデバイスを識別する様子を確認できます。
LFM3 Decision Models: Open-Vocabulary Detection in One Forward Pass - YouTube
LFM3は基盤モデルも含めてすべてオープンモデルとして公開されています。
💧 LFM3 - a LiquidAI Collection
https://huggingface.co/collections/LiquidAI/lfm3