どうも!オペ部の西村祐二です!
Cloudflare AI Search のキーワード検索は、デフォルトのトークナイザ porter のままだと、日本語の質問に結果を返さないことがあります。2026年10月16日の更新で trigram トークナイザが日本語・中国語・韓国語(CJK)のクエリに対応したので、ダッシュボードで porter と trigram のインスタンスを作り、検索結果を比べました。作成時に trigram を選んだインスタンスでは日本語の質問がヒットしましたが、既存のインスタンスで後から切り替えた場合は、今回試した範囲では検索結果が変わりませんでした。
今回の変更点
- 日付: 2026年10月16日(Cloudflare Changelog)
- 変更の要点:
trigramトークナイザのキーワード検索で、CJKのクエリでも文書がマッチするようになりました。経費精算の締め日はいつですか?のように、スペースを含まない自然文の質問も対象です。changelog によると、これまではスペースのないクエリが1つの完全一致フレーズとして扱われ、多くの場合キーワード検索の結果が返りませんでした - 案内されている設定: changelog とドキュメントは、CJKのコンテンツなら
keyword_tokenizerをtrigramにするよう案内しています。トークナイザを変えると全件の再インデックスが走ります
トークナイザは、インスタンスの indexing_options にある keyword_tokenizer で選びます。選択肢は2つです。
| トークナイザ | 分割のしかた | ドキュメントでの用途 |
|---|---|---|
porter(デフォルト) |
スペースと句読点で区切り、Porterステミングをかける(running が run にマッチする) |
自然言語 |
trigram |
1文字ずつずらしながら3文字の並びに分ける(config が configuration にマッチする) |
コード、CJKのコンテンツ |
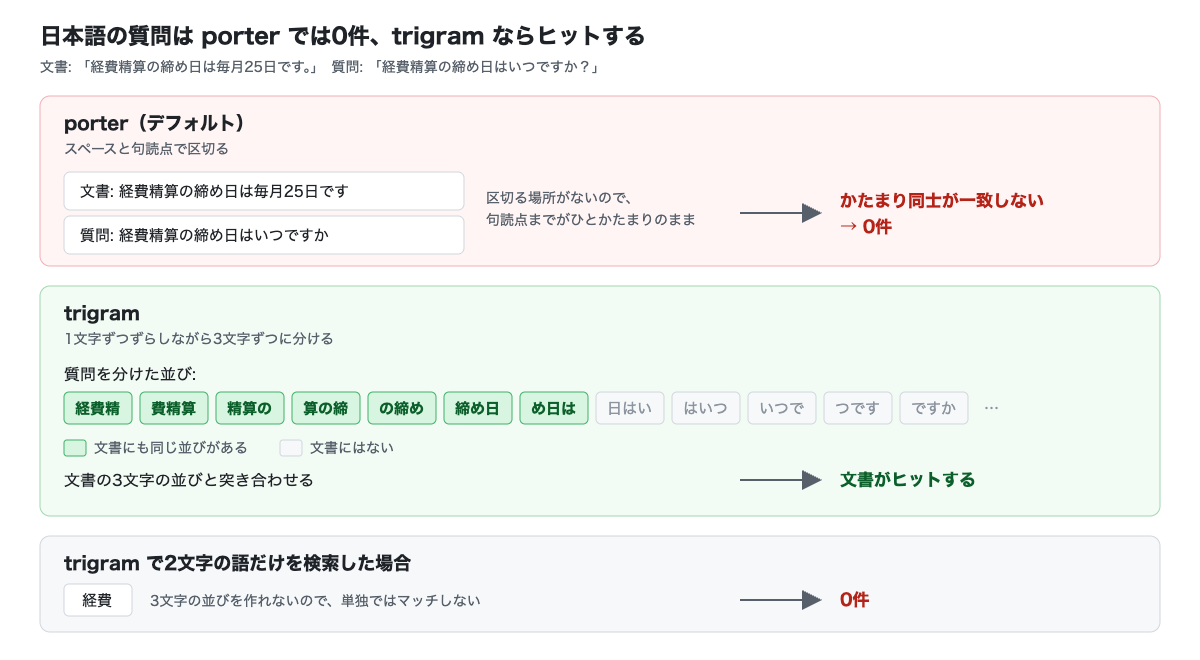
ドキュメントによると、日本語と中国語は単語をスペースで区切らず、韓国語は単語に助詞が付くため、porter では語ごとに分けられません。trigram にも制約があり、3文字より短い語は単独ではマッチしません。
同じ文書を同じ質問文で検索したときに、2つのトークナイザでどう違うかを図にしました。ドキュメントの説明と、後述の検証結果をもとに自作した概念図です。
試してみる
環境
- 2026年11月5日、Workers Free プランのアカウント
- ダッシュボード(日本語表示)で操作しました。AI Search の課金は2026年12月1日に始まる予定(Limits & pricing)で、検証時点では課金されません
- データソースは組み込みストレージで、作成後にインスタンスの「アイテム」タブの「ファイルをアップロード」から、次の2つの Markdown ファイルを入れました
# 経費精算のルール

経費精算の締め日は毎月25日です。25日までに申請された経費は、翌月10日に給与と一緒に振り込まれます。

交通費を申請するときは、領収書の画像を添付してください。
# 有給休暇の申請

有給休暇は、取得する日の3営業日前までにワークフローから申請してください。

半日単位でも取得できます。
新しいインスタンスは、デフォルトでベクトル検索とキーワード検索の両方が有効なハイブリッド検索になります。今回はベクトル検索の結果が混ざらないよう、検索方式をキーワード検索だけにしました。キーワード一致モード(AND)や一致しきい値(0.4。結果として返すのに必要な最小スコア)など、そのほかの設定はデフォルトのままです。
1. 作成時にトークナイザを選ぶ
ダッシュボードの「AI Search」で、「名前空間を作成」ボタンの右の矢印から「インスタンスを作成」を選びます。名前を付け、データソースは「組み込みストレージ」のまま「次へ」に進みます。「設定を確認」の「インデックス作成」で「もっと表示」を開くと、検索方式(SEARCH METHOD)とキーワード検索の設定(KEYWORD SETTINGS)が出てきます。「キーワードトークナイザ」の「編集」から「文字トリグラム」を選ぶと trigram になります。
次の画像は、検索方式を「Keyword search」だけにして「文字トリグラム」を選んだ状態です。赤枠(追記)は、選んだ検索方式とトークナイザです。
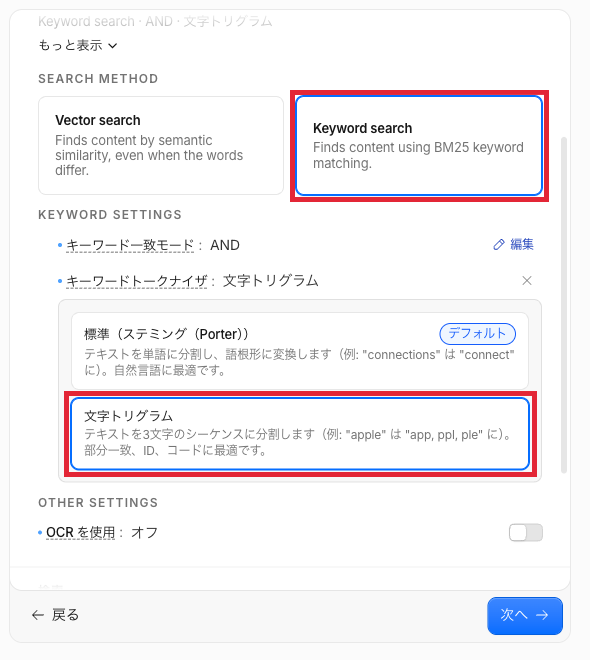
2026年11月5日時点で、ダッシュボードの「文字トリグラム」の説明は「部分一致、ID、コードに最適です」となっていて、CJKの記載はありません。
この手順で、トークナイザだけが違う2つのインスタンスを作りました。
ynishimura-cjk-porter: 標準(ステミング(Porter))ynishimura-cjk-trigram: 文字トリグラム
2. 同じ質問文で検索結果を比べる
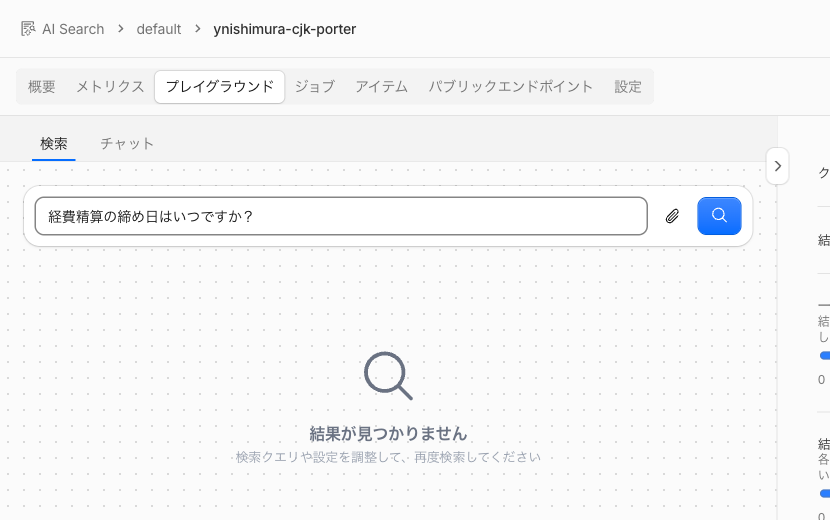
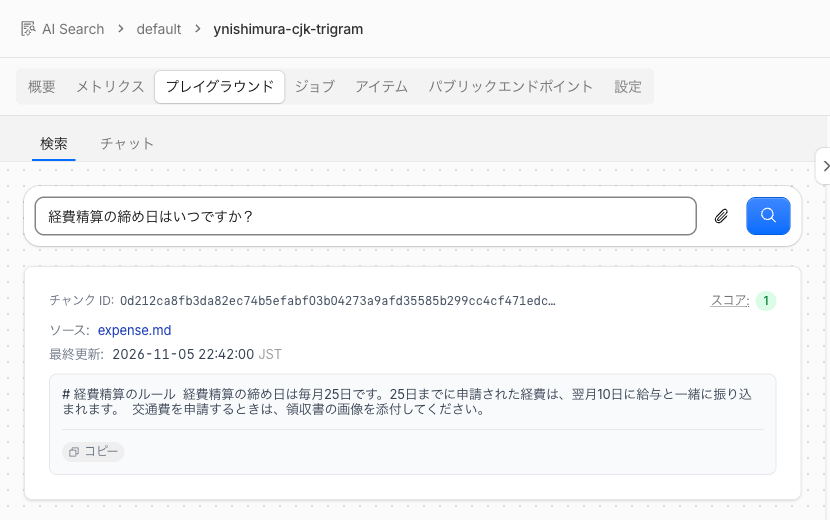
インスタンスの「プレイグラウンド」タブの「検索」に、changelog の例と同じ 経費精算の締め日はいつですか? を入れました。
porter のインスタンスは「結果が見つかりません」でした。一致しきい値を0に下げても同じです。
trigram のインスタンスは expense.md のチャンクを返し、paid-leave.md は返しませんでした。キーワード一致モードは AND のままですが、質問の3文字の並び(はいつ、ですか など)がすべて文書にある必要はありませんでした。
ほかのクエリも試しました。
| インスタンス | クエリ | 結果 |
|---|---|---|
porter |
経費精算 |
0件 |
trigram |
締め日(3文字) |
expense.md がヒット |
trigram |
経費(2文字) |
0件(一致しきい値0でも0件) |
経費精算 は文書にそのまま出てくる語ですが、porter では0件でした。文書側が句読点までひとかたまりのままなので、語だけでは一致しません。経費 の0件は、3文字より短い語は単独ではマッチしないというドキュメントの説明どおりです。日本語には「経費」「申請」のような2文字の語が多いので、2文字の語だけで検索されることが多い使い方では、この制約を見込んでおく必要があります。
3. 既存インスタンスで後から切り替える
すでに porter で運用しているインスタンスを trigram に切り替える場面を想定して、ynishimura-cjk-porter のトークナイザを後から変えました。インスタンスの「設定」タブで「Keyword tokenizer」の「編集」を選ぶと、選択肢と一緒に「Saving a new keyword tokenizer triggers a full re-index of this AI Search instance.」(新しいトークナイザを保存すると全件の再インデックスが走る)という警告が出ます。赤枠(追記)は、選んだ「文字トリグラム」とこの警告です。
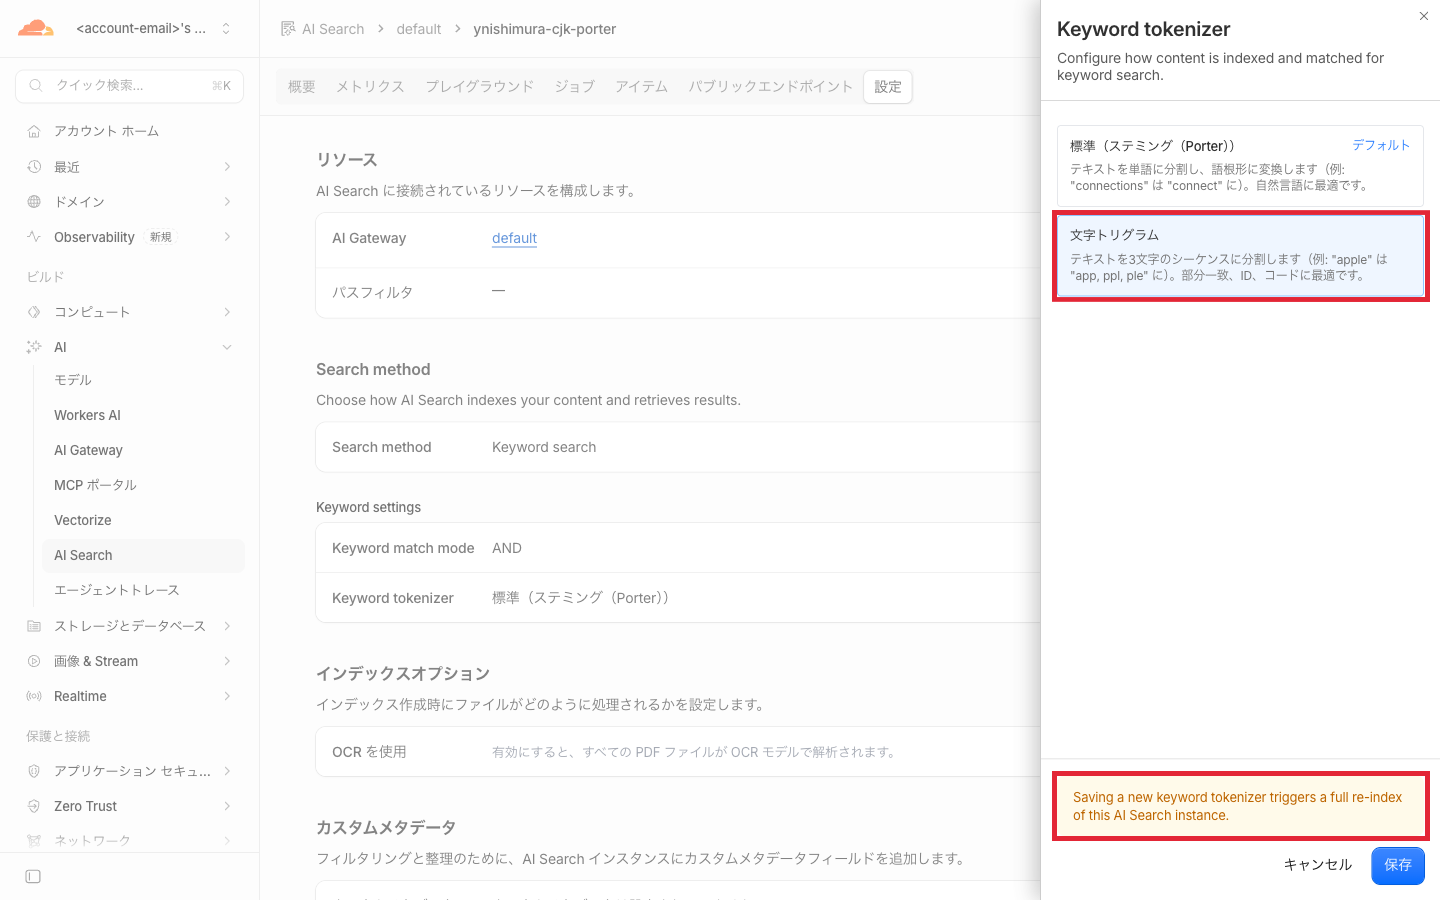
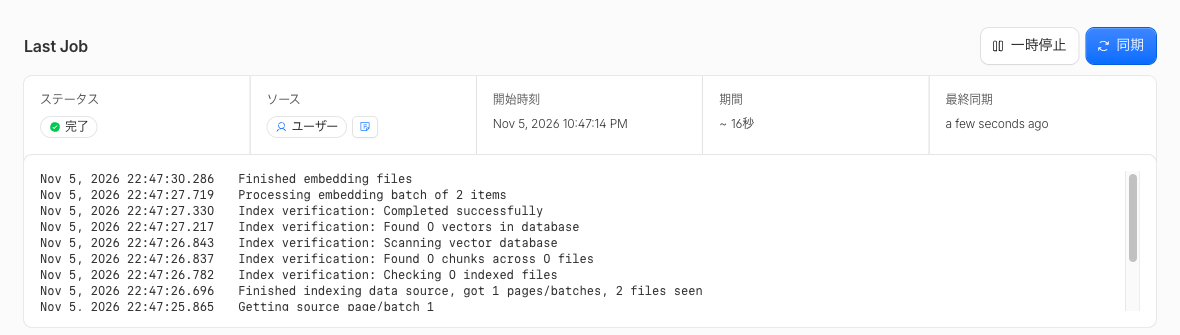
保存すると4秒後にジョブが始まり、約16秒で完了しました。ログの Processing embedding batch of 2 items と 2 files seen が、2つのファイルを処理し直した記録です。設定タブの表示も「文字トリグラム」に変わり、ダッシュボードが取得するインスタンスの設定も keyword_tokenizer: "trigram" になっていました。
ところが、作成時から trigram のインスタンスならヒットするクエリが、0件のままでした。
| 試したこと | 結果 |
|---|---|
切り替え直後から約9分後までに、文の途中の部分を含むクエリ(経費精算の締め日はいつですか?、締め日、申請は など)で検索 |
すべて0件(同じ時刻に、作成時から trigram のインスタンスではヒット) |
| 設定タブで類似性キャッシュをパージしてから検索 | 0件 |
| ジョブタブの「同期」でフル同期してから検索 | 0件 |
切り替えた後に新しいファイル(出張の申請は、出発日の5営業日前までに…)を追加し、出張の申請はいつまで? で検索 |
0件 |
このファイルを、作成時から trigram のインスタンスにも追加して同じクエリで検索 |
追加したファイルがヒット |
切り替えたインスタンスでヒットしたのは、文書中で読点の手前までひと続きになっている 出張の申請は で検索したときだけでした。スペースと句読点で区切る porter の区切り方と合う結果です。
逆向きも試しました。trigram で作った ynishimura-cjk-trigram を porter に切り替え、再インデックスのジョブ(3ファイル、約14秒)が終わってから類似性キャッシュをパージしました。このインスタンスで初めて使う 営業日前 で検索すると、porter なら一致しないはずの文の途中の部分でもヒットしました。こちらも作成時の trigram と同じ結果です。
コードでトークナイザを指定する場合
Workers からインスタンスを作る場合は、namespace binding(ai_search_namespaces)の create() に indexing_options.keyword_tokenizer を渡します。次の例は Workers binding のリファレンスのパラメータ定義から組み立てたもので、今回は実行していません。
// wrangler の設定で ai_search_namespaces に AI_SEARCH をバインドしている前提
// fetch ハンドラなど、env を受け取る関数の中で呼ぶ
const instance = await env.AI_SEARCH.create({
  id: "my-instance",
  // index_method を省略すると、ベクトル検索とキーワード検索のハイブリッド検索になる
  indexing_options: { keyword_tokenizer: "trigram" },
});
リファレンスによると、アカウントで一度も AI Search のインスタンスを作ったことがない場合は、サービス API トークンの token_id も必要です。update() でも indexing_options を渡せますが、update() で切り替えた場合に検索結果が変わるかは試していません。また、2026年11月5日時点の Wrangler CLI のドキュメントでは、ai-search create と ai-search update にトークナイザを指定するフラグがありません。Wrangler を使う場合も、トークナイザはダッシュボードか Workers binding、REST API で指定することになります。
検証結果の考察
- 確認できたこと: 作成時に
trigramを選んだインスタンスは、changelog の例と同じ日本語の質問でヒットし、porterは0件でした。porterは句読点までをひとかたまりにするので、文書中にそのまま出てくる経費精算でも一致しませんでした - 公式情報と照合したこと: トークナイザを変えると再インデックスのジョブが走ることは、ドキュメントとダッシュボードの警告どおりでした。ドキュメントには、変えると全件の再インデックスがトリガーされることだけが書かれていて、切り替えた後の検索結果がいつ変わるかには触れていません
- 運用上の注意点:
- 既存インスタンスでトークナイザを切り替えたら、日本語の質問で検索して結果が変わったかを確かめます。変わらなければ、
trigramで新しいインスタンスを作ってデータを入れ直します - ハイブリッド検索はベクトル検索とキーワード検索を並行して実行し、結果を統合します(Hybrid search)。そのため、デフォルトのハイブリッド検索では、
porterでキーワード側が0件でもベクトル検索側の結果は返ると考えられ、検索結果の全体からは気付きにくい可能性があります。ドキュメントによると、ハイブリッド検索では各チャンクに付くscoring_detailsのkeyword_scoreやkeyword_rankでキーワード側の結果を確かめられます(どちらも今回は試していません) - 再インデックスの所要時間や課金への影響は、ドキュメントに書かれていません。今回の2〜3ファイルは14〜16秒で終わりましたが、データ量の多いインスタンスでの所要時間は試していません。12月1日からの課金では取り込み(インデックスしたチャンクのトークン数)も対象になるので、作り直すときは Limits & pricing の料金も見ておく必要があります
- ダッシュボードでインスタンスを作る過程で、AI Gateway の
defaultと名前空間のdefaultが自動で作られ、インスタンスを削除しても残りました。今回は検証後に AI Gateway を削除し、課金のない名前空間は空のまま残しています
- 既存インスタンスでトークナイザを切り替えたら、日本語の質問で検索して結果が変わったかを確かめます。変わらなければ、
まとめ
Cloudflare AI Search で日本語のキーワード検索を使うなら、インスタンスの作成時に keyword_tokenizer を trigram にします。2026年11月5日に試した範囲では、作成時に trigram を選んだインスタンスは自然文の質問でもヒットしました。一方、既存インスタンスをダッシュボードで後から切り替えた場合は、約9分待っても検索結果が変わりませんでした。既存インスタンスは切り替えた後に日本語の質問で結果を確かめ、変わらなければ作り直します。2文字の語は単独ではマッチしない点も見込んでおきます。
誰かの参考になれば幸いです。
参考リンク:
- AI Search keyword search supports Japanese, Chinese, and Korean queries(Cloudflare Changelog)
- Keyword search(Cloudflare AI Search docs)
- Hybrid search(Cloudflare AI Search docs)
- Workers binding(Cloudflare AI Search docs)
- Limits & pricing(Cloudflare AI Search docs)
- Wrangler CLI(Cloudflare AI Search docs)