こんにちは、せーのです。
作業動画から手順書を作りたい、という話は生成AIの登場でかなり身近になりました。動画のフレームを切り出して Claude に渡せば、「何をしているか」の説明はそれっぽく返ってきます。
ですが、手順書として読むと、どうしても「見た目の説明」で止まるんですよね。「ハンドルを回している」とは書けても、どれくらい回したのかは画像を眺めているだけでは出てきません。そこで、生成AIが切った工程の中に、骨格の座標から測った数値を差し込んだらどうなるか、を試しました。
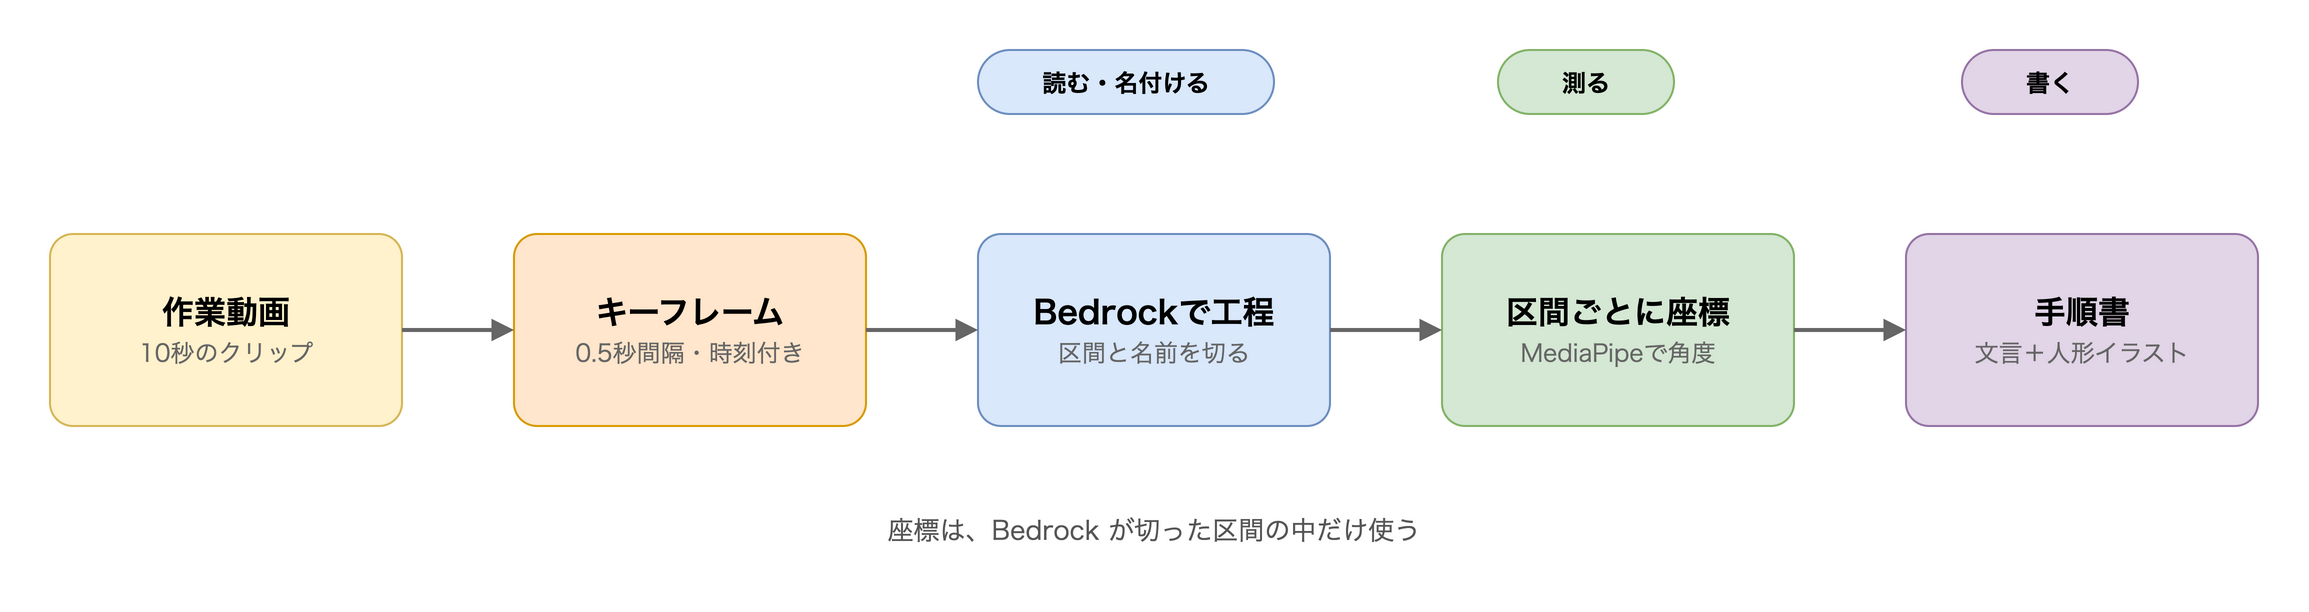
結論から言うと、「生成AIが工程を切る → その区間の中だけ座標で測る → 文言とイラストの手順書にする」という流れは、10秒の動画で最後まで通りました。 「+16.2° ハンドルを切る」という文言の横に、16.2°回した人形のイラストを並べた一枚のレポートまで出ています。
ただし、この角度は 画像上で両手首を結んだ線の変化 であって、ハンドルの切れ角そのものではありません。フレームごとの角速度は姿勢推定の揺れでほぼ使えない、などの落とし穴もあったので、そのへんはそのまま残します。以下は 2026-11-05〜06 に取った記録です。
やりたかったこと
手順書に必要なのは、ざっくり言うと次の2つです。
- 何をするか(工程の名前と順番)
- どう動かすか(角度、タイミング、速さ)
前者は画像を見ないと決まりません。後者は数値がないと「それっぽい説明」で止まります。
以前、骨格の座標だけでルールを組んで工程を切ろうとしたことがあるのですが、これはうまくいきませんでした。区切りの位置はそこそこ取れても、名前付けが弱いんです。手の動きが似ている工程は、手に持っている道具を見ないと区別できないので、座標だけでは限界があります。
ということで、役割を分けることにしました。
| 役 | 担当 | やること |
|---|---|---|
| 読む・名付ける | 生成AI(Amazon Bedrock の Claude) | キーフレームから「この秒からこの秒まで、何をしているか」を切る |
| 測る | 姿勢推定(MediaPipe) | 切られた区間の中だけ、関節の角度や変化を計算する |
| 書く | 生成AI + テンプレート | 測った数値だけを使って、文言とイラストにする |
違いを整理すると、生成AIは「何をしているか」を決める役、座標は「どれだけ動いたか」の根拠を出す役、というイメージです。
姿勢推定のモデル(おさらい)
ここで一度おさらいです。姿勢推定と一口に言っても、取れる点の数がモデルによってだいぶ違います。
| モデル | 取れる点 | 今回の使い方 |
|---|---|---|
| MediaPipe Pose Landmarker | 全身33点(肩・肘・手首・腰・膝など。指は付け根の大まかな位置まで) | 今回使用。手首と肘の角度を計算 |
| MediaPipe Hand Landmarker | 片手21点(指の関節まで) | 今回は検出率の確認のみ |
| RTMW(RTMPose 系) | 全身133点(体・足・顔・両手) | 今回は未使用 |
MediaPipe は指先専用と思われがちですが、Pose Landmarker で全身も取れます。ただし33点の中に指の関節はほぼないので、指の曲げまで見るなら Hand Landmarker を別にかけることになります。全身も指も一度に欲しい場合は、RTMW のような133点のモデルを使う手もあります。
今回は「両手首がハンドルの上でどう動いたか」を見たいので、Pose Landmarker の手首・肘・肩で十分、と判断しました。
使った動画と座標
題材は、Intel の sample-videos リポジトリにある運転席の動画 driver-action-recognition.mp4 です。その100〜110秒を、幅480px・15fps に切り出しました。リポジトリの LICENSE は CC BY 4.0 です(個別の動画ファイルの出所までは確認できていません)。
座標は、事前に CPU だけ(4 vCPU)で MediaPipe をかけて取ってあったものを使っています。そのときの結果は次のとおりです。
| 項目 | 値 |
|---|---|
| フレーム数 | 150(10秒 × 15fps) |
| 骨格(33点)の検出 | 150/150(100.0%) |
| 手(21点)の検出 | 90/150(60.0%) |
| 推論のみ | 18.04 fps |
| 読み込み・描画込み | 17.15 fps |
上半身が大きく写る10秒なら、CPU だけでもほぼリアルタイムで骨格が取れる、という桁感ですね。
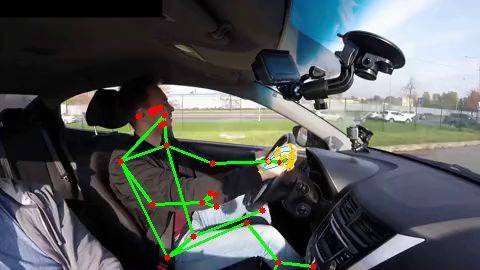
ここで1つ注意があります。手首の確信度(visibility)が低いんです。
both wrists v>=0.3: 150/150
both wrists v>=0.4: 143/150
both wrists v>=0.5: 48/150
both wrists v>=0.6: 0/150
両手首が0.5以上取れたのは150フレーム中48、0.6以上は0件でした。ハンドルの陰に手が入る構図なので、まあそうなりますよね。今回は数値を出す下限を0.4にして、区間ごとに0.5以上のフレーム数も併記することにしました。
やってみた
- リージョン:
ap-northeast-1(東京) - モデル:
global.anthropic.claude-sonnet-5-5(グローバル推論プロファイル) - API: Bedrock Converse API(boto3)
- 入力: 上の10秒クリップと、その座標JSON(MediaPipe は再実行していません)
Step 1: キーフレームから工程を切る
まず動画から0.5秒間隔で20枚のキーフレームを切り出し、左上に時刻を書き込みます。それを Converse API にまとめて渡して、0.0〜10.0秒を隙間なく覆う工程のJSONを返してもらいます。
ここでのポイントは、生成AIに数値を書かせないことです。角度や速さは座標側で出すので、生成AIには「見えている動作」だけを書いてもらいます。
def image_blocks(items):
    blocks = []
    for it in items:
        blocks.append({"text": f"時刻 {it['t']:.1f} 秒のキーフレーム。"})
        blocks.append({
            "image": {
                "format": "jpeg",
                "source": {"bytes": it["path"].read_bytes()},
            }
        })
    return blocks

step_system = (
    "あなたは作業動画のキーフレームを見て、工程の区間を切る係です。"
    "測定値(角度、速さ、回数、距離)は書かない。画面に見えない道具、材料、意図、目的は書かない。"
    "出力はJSONオブジェクトだけ。前置きも後書きも書かない。"
)

resp = client.converse(
    modelId="global.anthropic.claude-sonnet-5-5",
    system=[{"text": step_system}],
    messages=[{"role": "user", "content": image_blocks(items) + [{"text": step_user}]}],
    inferenceConfig={"maxTokens": 2000},
)
ちなみに、最初は再現性のために temperature: 0.0 を付けていたのですが、
botocore.errorfactory.ValidationException: An error occurred (ValidationException) when calling the Converse operation: The model returned the following errors: `temperature` is deprecated for this model.
と怒られました。このモデルでは temperature が指定できないようです。maxTokens だけにしたら通りました。
返ってきた工程はこちらです。
| 秒 | 生成AIが切った工程 |
|---|---|
| 0.0–2.0 | 片手でハンドルを握り、前方を向いて車を走らせている |
| 2.0–5.0 | 顔を左右や下に動かしながら、ハンドルを握って運転を続けている |
| 5.0–6.5 | 場面が切り替わり、明るい屋外の道で両手でハンドルを操作している |
| 6.5–8.5 | 両手でハンドルを回して車を操作し、前方を見ている |
| 8.5–10.0 | 片手でハンドルを持ち、もう一方の手を上げて身振りをしたあと、頭の近くに手を当てている |
5秒付近で景色が駐車場から緑地の道に変わるところや、終盤に片手を顔の近くへ上げるところは、キーフレームを見比べても確かにそうなっています。区切りの位置と名前は、画像側に任せて問題なさそうですね。
Step 2: 区間の中だけ座標で測る
次に、この工程の区間ごとに、座標から数値を出します。今回の主役は 両手首を結ぶ線の角度 です。
def wrist_line_deg(pose, names):
    rw = lm(pose, "right_wrist", names)
    lw = lm(pose, "left_wrist", names)
    if not (visible(rw) and visible(lw)):
        return None
    return math.degrees(math.atan2(lw["y"] - rw["y"], lw["x"] - rw["x"]))
両手でハンドルを持っていれば、ハンドルを回すと両手首を結ぶ線も傾きます。なので、この線の向きが区間の最初から最後までにどれだけ変わったかを見れば、「どれくらい回したか」の手がかりになる、という考え方です。
ただし、あくまで 画像平面上の角度 です。カメラは斜め横から撮っているので、ハンドルの実際の切れ角とは一致しません。ここは記事の中でも、レポートの中でも、何度も書いておきます。
測ってみた結果がこちらです。
| 秒 | 手首線の始め → 終わり | 区間の変化 | 正味の変化率 | 両手首 v≥0.5 |
|---|---|---|---|---|
| 0.0–2.0 | -47.8° → -54.3° | -6.5° | -3.2°/秒 | 10 |
| 2.0–5.0 | (使わない) | — | — | 0 |
| 5.0–6.5 | -46.3° → -39.8° | +6.5° | +4.3°/秒 | 11 |
| 6.5–8.5 | -54.8° → -38.6° | +16.2° | +8.1°/秒 | 15 |
| 8.5–10.0 | -53.3° → +13.6° | +66.9° | +44.6°/秒 | 12 |
「ハンドルを回している」と生成AIが言った6.5–8.5秒は、手首の線が +16.2° 動いていました。一方で最後の8.5–10.0秒は +66.9° と大きく動いていますが、これは片手を頭の近くへ上げたことで線が大きく傾いただけです。実際、この区間は両手首の平均の高さが肩より上(肩幅で割って左 0.34、右 0.73)に来ています。
つまり、同じ「角度の変化」でも、工程の名前がわかっていないと意味を読み違えるわけです。座標だけで「66.9°も切った!」と書いてしまうと、完全に嘘になります。ここは生成AIに工程を切らせた効果が素直に出たところですね。
2.0–5.0秒は、両手首が0.5以上取れたフレームが0件だったので、角度は手順に載せないことにしました。
落とし穴: フレームごとの角速度は使えない
最初は「どのくらいの速さで回したか」も出そうとして、隣り合うフレーム間の角度差から角速度を計算していました。
"mean_abs_wrist_line_speed_deg_per_s": 77.2,
"peak_abs_wrist_line_speed_deg_per_s": 370.7,
、、、毎秒370°。区間全体では16.2°しか動いていないのに、です。
これは15fpsのフレーム間で、姿勢推定の手首の位置がちょっとずつブレるのを拾っているだけだと推測できます。手首の確信度が0.4〜0.5あたりをうろうろしているので、なおさらですね。
ということで、手順に載せる速さは 区間の角度の変化を区間の秒数で割った値(正味の変化率)だけにしました。6.5–8.5秒なら 16.2° ÷ 2.0秒 = 8.1°/秒です。
Step 3: 数値を手順書の文に埋め込む
工程と数値をまとめて Converse API に渡し、手順書の下書きにしてもらいます。ここでのシステムプロンプトのポイントは次のとおりです。
- 工程の名前と区間は、Step 1 の結果だけを使う
- 数値は、入力にあるものだけを小数のまま引用する
- 手首の線の角度は、ハンドルの切れ角と書かない
- 確信度が足りない区間は、角度も速さも書かない
、、、と、ここでまたつまずきました。座標の指標を全部渡したら、モデルが律儀に全部の数値を書き写そうとして、2回連続で max_tokens に達して途中で切れました。
"stop": "max_tokens"
手順に使う数値(区間の最初と最後の角度、変化、正味の変化率、肩に対する手首の高さ)だけに絞って渡し直したところ、3回目で最後まで出ました。
4. 6.5〜8.5秒:両手でハンドルを回す動作。画像上の両手首の傾きの変化は16.2度(8.1度/秒)で、これだけ。大きく切ったとは書かない。
5. 8.5〜10.0秒:片手でハンドルを持ち、もう一方の手を上げて身振りをし、頭の近くに手を当てる。手首の高さは左0.34、右0.73で、どちらも肩より上。手首線は-53.3度から13.6度で、変化は66.9度(44.6度/秒)。手を上げた動きによる変化で、ハンドル操作量ではない。
5番目は、きちんと「ハンドル操作量ではない」と書き分けてくれていますね。
一方で4番目の「大きく切ったとは書かない。」は、私がシステムプロンプトに書いた指示がそのまま本文に漏れています。数値の扱いは守ってくれていますが、手順書としてそのまま出すには一手間いりますね。この揺れもあって、最終的なレポートの文言は、生成AIの文をそのまま貼るのではなく、工程と数値から組み立てる形にしました。
生成AIに渡す情報は、多ければ多いほど良いわけではない、というのは地味に効く学びでした。
比較のために、同じキーフレームだけで(座標なしで) 手順書を書かせたものも作りました。こちらは「片手でハンドルに添える」「場面が切り替わる」「片手を頭の後ろ付近まで上げる」までは書けていて、ハンドルの操作量は「測定できていない」と要確認に回していました。嘘は書かないけれど、どれだけ動いたかは言えない、という状態です。
違いを整理すると、キーフレームだけの手順書は「何をしているかの説明」、座標を足した手順書は「どれだけ動いたかの根拠つきの説明」、というイメージです。
Step 4: 文言とイラストの一枚レポートにする
数値が入った手順書も、文章だけだとやっぱり読みにくいんですよね。「+16.2°」と書かれても、ぱっとイメージできる人は少ないと思います。
ということで、最後に 文言の横に顔のない人形のイラストを並べた一枚のレポート を作る仕組みにしました。
- 左に手順の文言(「+16.2° ハンドルを切る」など)
- 右に人形。円がハンドルで、灰色の印が回す前、オレンジの印と矢印が測った角度だけ回した位置
- 手を上げる工程は、手を上げた姿勢の人形にして、角度はハンドル操作として描かない
- 角度が出せなかった区間は「角度なし」
イラストは SVG をスクリプトで組み立てていて、工程のJSONから HTML を作り、Chrome のヘッドレスで PDF にしています。画像生成AIは使っていません。角度をそのまま図に反映させたかったので、測った数値がそのまま描画に入るようにしています。
def wheel_turn(cx, cy, radius, delta):
    start = -90
    end = start + delta
    ...
できあがったのがこちらです。
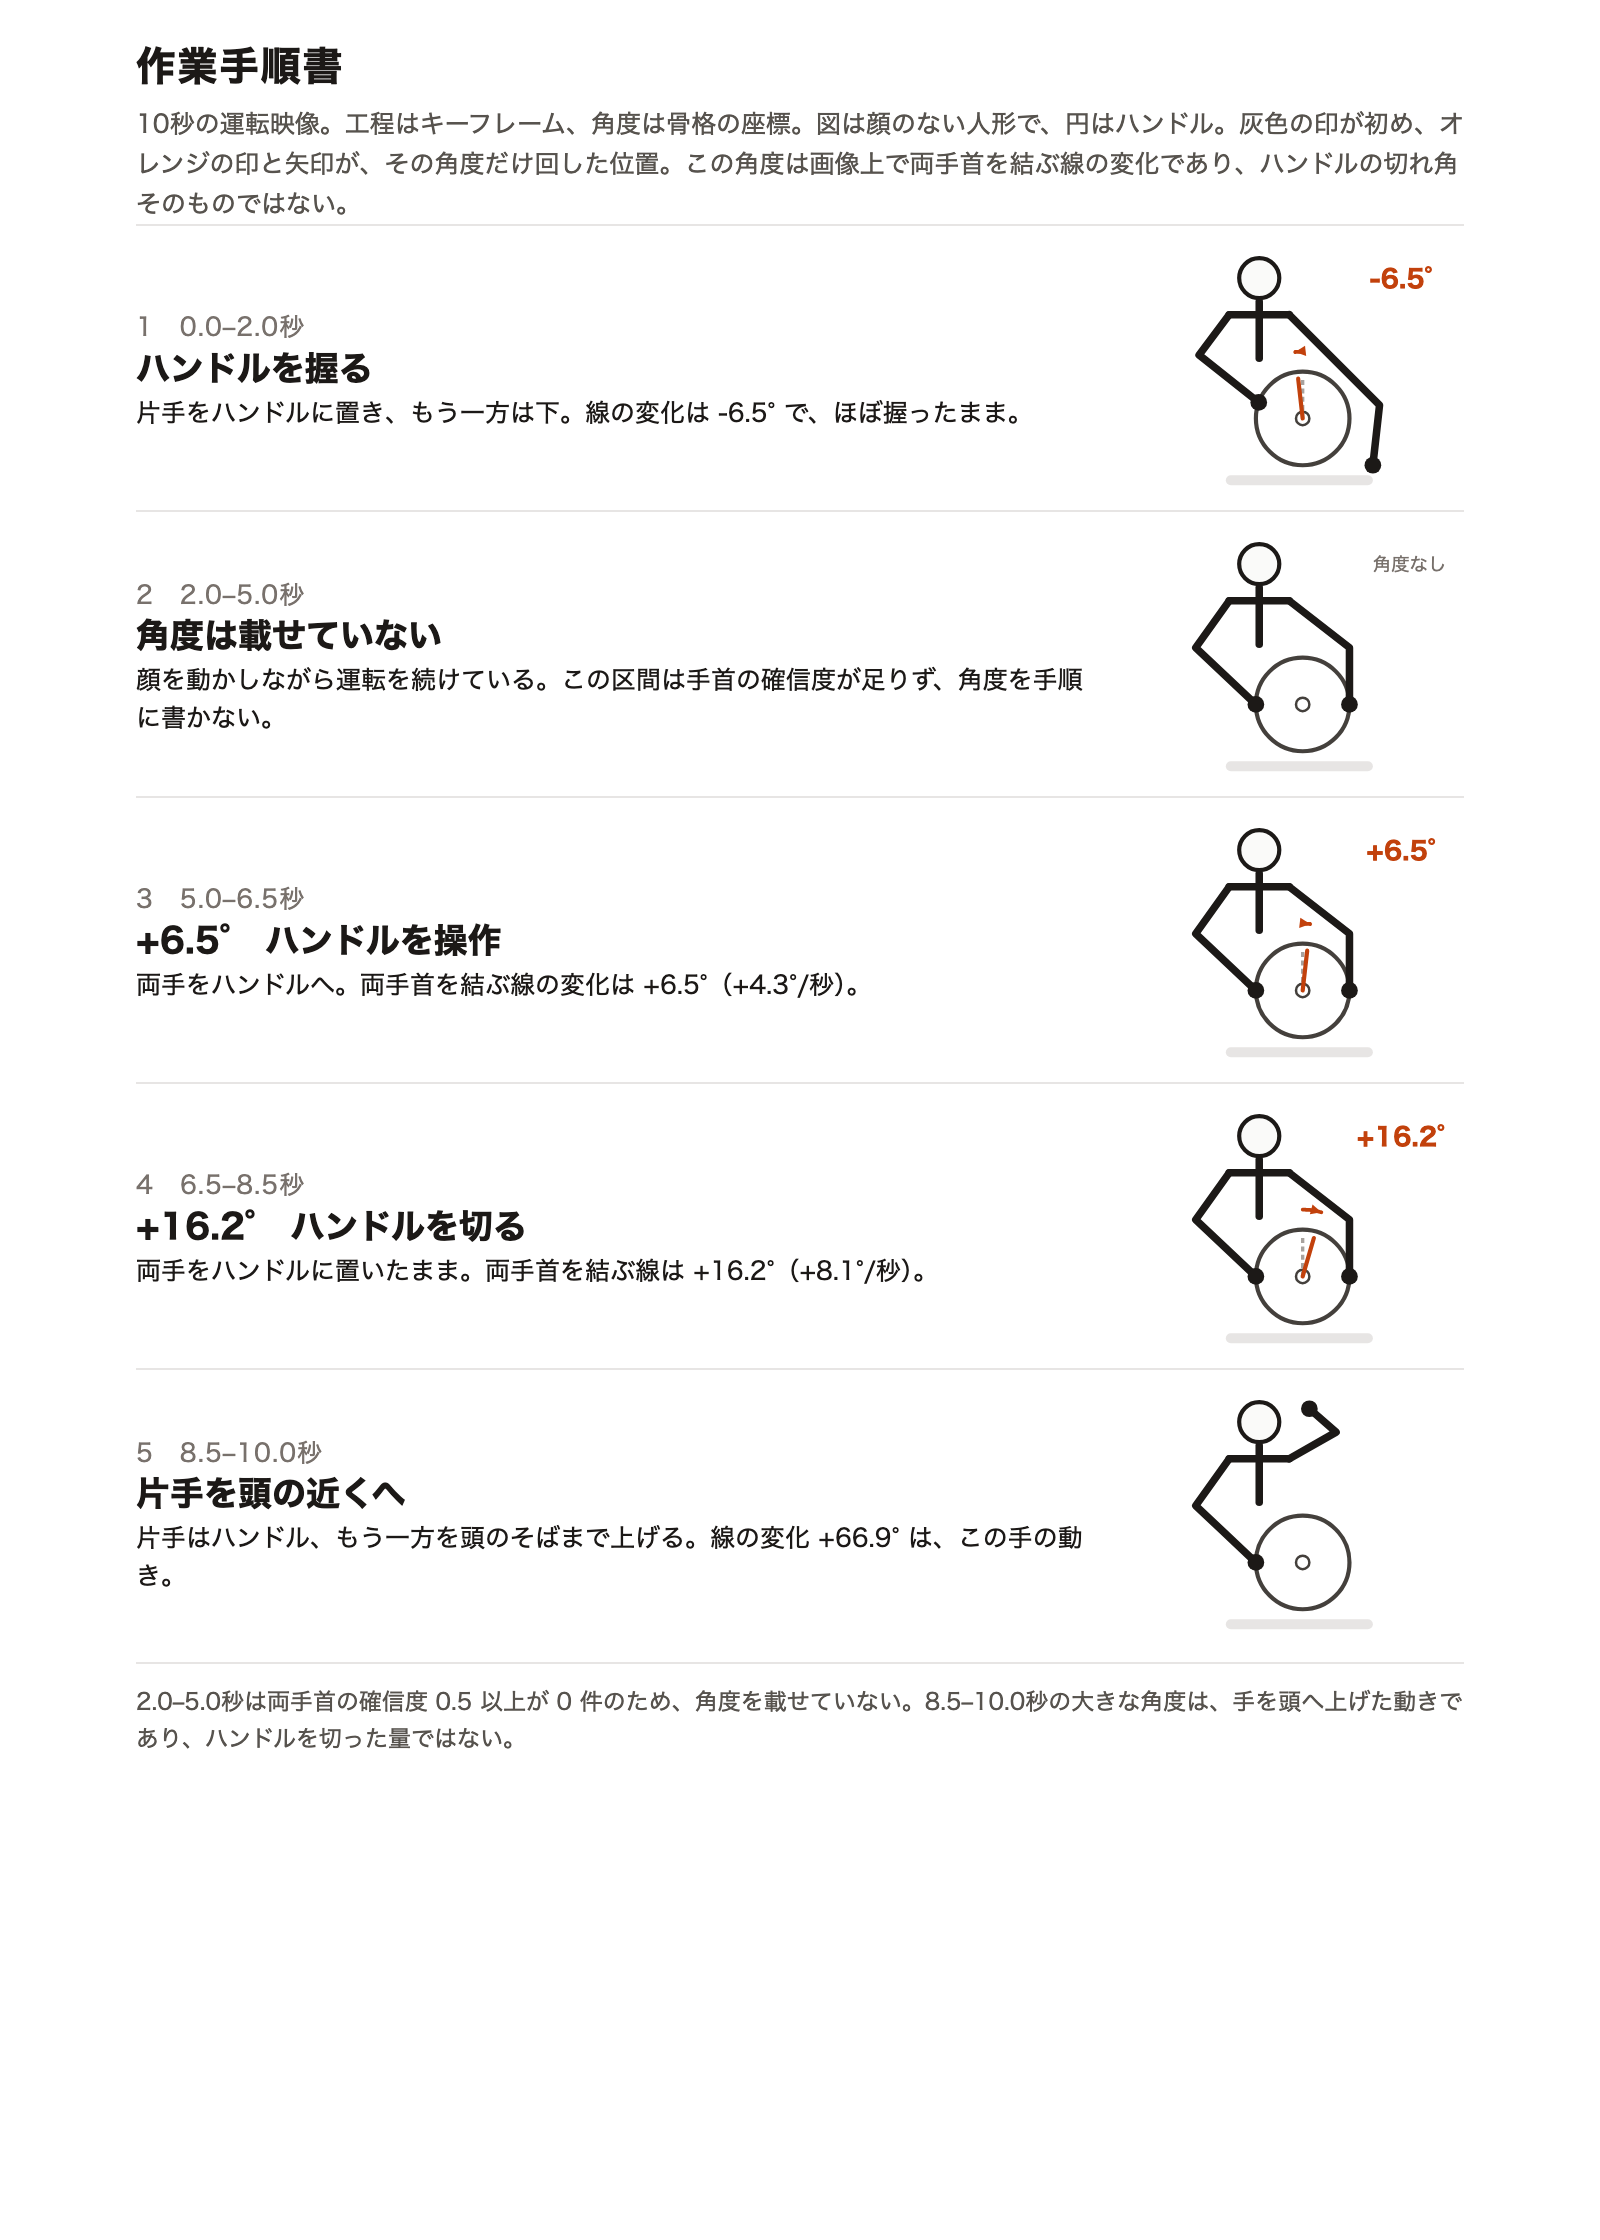
4番目の「+16.2° ハンドルを切る」の横に、ハンドルを16.2°回した人形が並んでいます。文字だけのときより、だいぶ読みやすくなりました。
まとめ
- 作業動画から手順書を作るなら、生成AIで工程を切ってから、その区間の中だけ座標で測る 順番が筋よさそうです
- 座標だけでは「66.9°動いた」が手を上げた動きなのかハンドル操作なのか区別できません。工程の名前があってこそ、数値の意味が決まります
- フレームごとの角速度は姿勢推定の揺れを拾う ので、速さは区間全体の変化率で出すのが安全です
- Bedrock の Claude Sonnet 5.5(グローバル推論プロファイル)では
temperatureが指定できず、座標の指標を全部渡すとmax_tokensで切れました。生成AIには使う数値だけを渡す のがコツです - 文言だけでなく 測った角度をそのまま反映した人形イラスト を横に置くと、手順書としてぐっと読みやすくなります
次は、実際の作業動画で同じ流れを回して、職人さんの言葉と数値がちゃんと噛み合うかを見てみたいと思っています。
参考資料
- Pose landmark detection guide(MediaPipe)
- Hand landmarks detection guide(MediaPipe)
- Carry out a conversation with the Converse API operations(Amazon Bedrock)
- Amazon Bedrock の料金
- intel-iot-devkit/sample-videos(GitHub)
- [Amazon Bedrock] Claude で工場の作業動画から工程分析レポートを自動生成してみました
- 製造現場の動画と工程文書をつないで作業の異常候補を検索できるようにしてみた